Von bloßer SEO-Optimierung zu Webseiten, die von Mensch und KI gefunden und verstanden werden
Hier wird gezeigt, wie Kontext so publiziert werden kann, damit gefunden wird, was zählt - und verstanden wird, was gemeint ist. Mit überraschend einfachen Regeln.
Praxistipps für eilige Leser - vorab
Damit gefunden wird, was zählt - und verstanden wird, was gemeint ist
Es ist gar nicht selbstverständlich, dass Suchende das finden was sie meinen und diejenigen, die gerne gefunden würden, auch deswegen gefunden werden. Dazwischen liegt sehr viel vermittelnde Technik im Internet, die beide Seiten missverstehen kann. Zum Beispiel Suchmaschinen und Künstliche Intelligenz (KI). Damit diese ihre Aufgaben wie erhofft erfüllen, haben sich folgende "Do's und Don'ts" bei der Gestaltung von Webseiten und Unternehmenswissen (Kontext) bewährt.
Für alle, die Zweifel an gemachten SEO Versprechungen haben, empfehle ich das Lesen vom Rest dieses Fachartikels.
Rainer Tolksdorf - im September 2026
Do's
- Vom Kontext ausgehen.
Erst klären, was über das Unternehmen verstanden werden muss – dann Seiten und Navigation gestalten. - Konkret sagen, was das Unternehmen kann.
Fähigkeiten, Erfahrungen, Bedingungen und Grenzen beschreiben. - Unternehmenswissen wie ein gutes Buch strukturieren.
Themen aufeinander beziehen und Begriffe eindeutig verwenden. - Titel, Meta Description, H1 und H2 als Bedeutungsgerüst nutzen.
Schon daraus sollte verständlich werden, worum es geht. - Die Menschen erklären lassen, die etwas wissen.
Ihr Erfahrungswissen ist der wichtigste Rohstoff für Context Publishing.
Don'ts
- Nicht mit dem Seitendesign beginnen und danach mit Content befüllen.
Eine schöne einzelne Seite erklärt noch nicht den Zusammenhang. - Keine Managementfloskeln als Ersatz für Wissen.
„Innovativ“, „ganzheitlich“ und „kundenorientiert“ sind für Mensch und KI weder erklärend noch beeindruckend. - Nicht jede Seite als einzelnen SEO-Flyer optimieren.
Viele gute Einzelseiten ergeben noch keine verständliche Domain. - Nicht möglichst viele Keywords unterbringen und mit Bedeutung verwechseln.
Auffindbarkeit allein bedeutet noch keine richtige Einordnung. Keyword-Verwendung ohne Zusammenhang kann Indexer von Suchmaschinen und KI sogar verwirren. - Bedeutung nicht Suchmaschinen und KI allein überlassen.
Wo Zusammenhänge wichtig sind, sollten sie ausdrücklich publiziert werden. - SEO-Indexkurven als alleiniges Ziel der Optimierung sehen.
Sichtbarkeit bedeutet, Crawler können Inhalte sehen - mehr nicht. Was Suchmaschinen und KI real zu einer Suche ausspielen kann niemand garantieren und vorhersagen.
Wie diese Praxistipps zustande kamen
Um das schon erwähnte Ziel "damit gefunden wird, was zählt - und verstanden wird, was gemeint ist" zu erreichen, wurde die Digital Business Relevance Suite (DBRS - dazu später mehr) entwickelt. Als willkommenes Nebenprodukt der Entwicklung, ergaben sich die eingangs erwähnten Do's und Don'ts. Die Messungen, Erkenntnisse, Originaldokumente und Entwicklungsarbeiten sind als faktischer Erlebnisbericht erzählt.
Wir haben uns Mühe gegeben, so zu schreiben, dass der Text auch für nicht mit der Thematik vertraute Leser verständlich ist.
Falls doch mal etwas unklar oder ein Fachbegriff schlecht erklärt worden ist, fragen Sie doch unseren KI Innovation Mentor Samy.
Versprechungen, Beweise und Prüfbarkeit
Bei einer Suche im Internet oder einer Frage an eine KI wirken unterschiedliche technische Systeme zusammen. Wie diese im konkreten Fall Informationen auswählen, gewichten und verarbeiten, ist von außen nur teilweise bekannt. Es gibt Dokumentationen – vieles bleibt jedoch Geschäftsgeheimnis oder ist nicht vollständig beobachtbar.
Wir können solche Systeme durch die Informationen beeinflussen, die wir ihnen zugänglich machen. Wir können aber nicht bestimmen, was eine Suchmaschine oder KI bei einer konkreten Anfrage daraus macht.
Deshalb ist ein weiteres Don't besonders wichtig:
Keine garantierte SEO- oder sogenannte KI-Sichtbarkeit versprechen.
Was kann man zusagen und auch prüfbar umsetzen?
Sehr wohl lässt sich prüfen, ob die kontrollierbare Seite ordentlich gestaltet wurde: Sind relevante Informationen vorhanden? Sind Fähigkeiten und Zusammenhänge konkret beschrieben? Sind Begriffe eindeutig? Sind Informationen technisch erreichbar, strukturiert und maschinenlesbar?
Auch Dienstleister und Lösungsanbieter können dokumentieren, was sie umgesetzt haben, welche Annahmen dahinterstehen und was sich in Tests beobachten lässt. Aus Gegenbeispielen, Dokumentationen und neuen Beobachtungen können die Modellannahmen anschließend weiterentwickelt werden.
Das ist die Grenze zwischen überprüfbarer Arbeit und markigen Versprechungen im digitalen Marketing.
Aus verständlichen Seiten eine verständliche Domain machen
Wie aus DBRS ein Bedeutungsregister, eine Context World, das Context World Development System (CWDS) und einfache Regeln für Context Publishing wurden
Eine einzelne Webseite kann hervorragend gestaltet, technisch sauber erreichbar und mit strukturierten Daten beschrieben sein. Trotzdem bleibt ein grundsätzliches Problem: Eine Domain ist mehr als die Summe ihrer einzelnen Seiten.
Eine klassische Website kann wie ein Stapel guter Flyer wirken. Jeder Flyer ist für sich verständlich. Der vom Herausgeber gemeinte Zusammenhang zwischen den Flyern ist damit noch nicht automatisch als gemeinsame Bedeutung veröffentlicht.
Suchmaschinen, Indexer und KI-Systeme können solche Zusammenhänge selbst rekonstruieren. Sie nutzen Texte, Links, Navigation, Metadaten, strukturierte Daten und weitere Signale. Wie daraus intern Bedeutung entsteht, ist aber nur teilweise dokumentiert und von außen nicht vollständig beobachtbar.
Daraus entstand für DBRS eine zentrale Frage: Warum sollte der Herausgeber nur einzelne Informationen publizieren und die Rekonstruktion ihres Zusammenhangs vollständig anderen Systemen überlassen?
DBRS versucht nicht nur einzelne Webseiten maschinenlesbar zu machen. Es versucht zusätzlich, den vom Herausgeber gemeinten Zusammenhang einer Domain explizit und maschinenlesbar anzubieten.
Metadaten wie JSON-LD als Informationsanker
JSON-LD bedeutet JavaScript Object Notation for Linked Data. Ein einfaches Beispiel: Eine Bäckerei kann sich als LocalBusiness mit Name, Adresse, Telefonnummer und Öffnungszeiten maschinenlesbar beschreiben.
JSON-LD kann einzelne "übliche" Webseiten und Informationsobjekte maschinenlesbar beschreiben. Es kann beispielsweise kenntlich machen, dass eine Seite ein Unternehmen, eine Person, ein Produkt oder einen Datensatz beschreibt und dazu strukturierte Eigenschaften veröffentlichen.
Damit kann die einzelne Seite sehr gut beschrieben sein. Offen bleibt jedoch die Frage, wie der vom Herausgeber gemeinte Zusammenhang zwischen vielen solchen Seiten als Domain-Kontext veröffentlicht werden kann. Genau an dieser Stelle entwickelte sich DBRS weiter.
John Searle: Bedeutung braucht Kontext
Bei der Entwicklung von DBRS führte eine zunächst philosophische Frage überraschend schnell zu einem praktischen Problem: Was macht aus einer Information eigentlich Bedeutung?
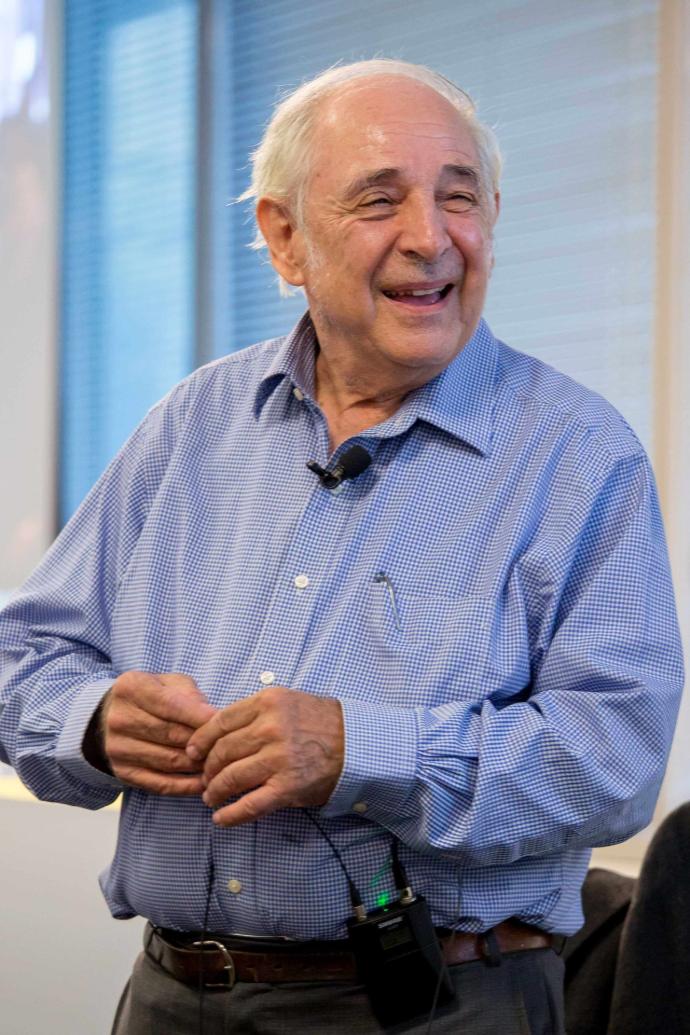
Der Philosoph John Searle verwendet im Zusammenhang mit institutionellen Tatsachen und Statusfunktionen die bekannte Formel:
„X counts as Y in context C.“
Vereinfacht gesagt: Was etwas ist oder bedeutet, lässt sich nicht immer allein aus dem betrachteten Objekt ableiten. Seine Einordnung hängt auch von dem Zusammenhang ab, in dem es steht.
Ein Beispiel:
- „Java“ zählt als Insel im Kontext der Geografie.
- „Java“ zählt als Programmiersprache im Kontext der Softwareentwicklung.
John Searle bei seinem Vortrag "Consciousness in Artificial Intelligence" bei Google in Mountain View - November 23, 2015.
Für DBRS blieb es nicht bei der philosophischen Theorie, sondern es entwickelte sich eine praktische Engineering-Frage:
Welche Bedeutung erhält eine Information in einem bestimmten Kontext – und wie kann diese Zuordnung digital möglichst zuverlässig rekonstruiert werden?
Genau hier zeigt sich eine Grenze der reinen Optimierung einzelner Webseiten. Eine Seite kann hervorragend geschrieben, für Suchmaschinen optimiert und mit strukturierten Daten beschrieben sein. Trotzdem müssen Suchmaschinen und KI-Systeme aus vielen einzelnen Informationsobjekten rekonstruieren, wie diese zusammengehören und was sie im Kontext des Unternehmens bedeuten.
Damit verschob sich unsere Fragestellung. Nicht mehr nur:
„Wie machen wir eine Information auffindbar?“
sondern zusätzlich:
„Wie veröffentlichen wir den Zusammenhang, in dem sie gemeint ist?“
Daraus entstand ein zentraler Gedanke von DBRS und Context Publishing:
Nicht nur Informationen publizieren. Den gemeinten Zusammenhang mitpublizieren.
Von E-E-A-T zur Erkennbarkeit eines Unternehmens
Parallel beschäftigten wir uns intensiv mit Suchmaschinenoptimierung und Googles E-A-T-Konzept. E-A-T stand zunächst für Expertise, Authoritativeness und Trustworthiness – Fachwissen, Autorität und Vertrauenswürdigkeit.
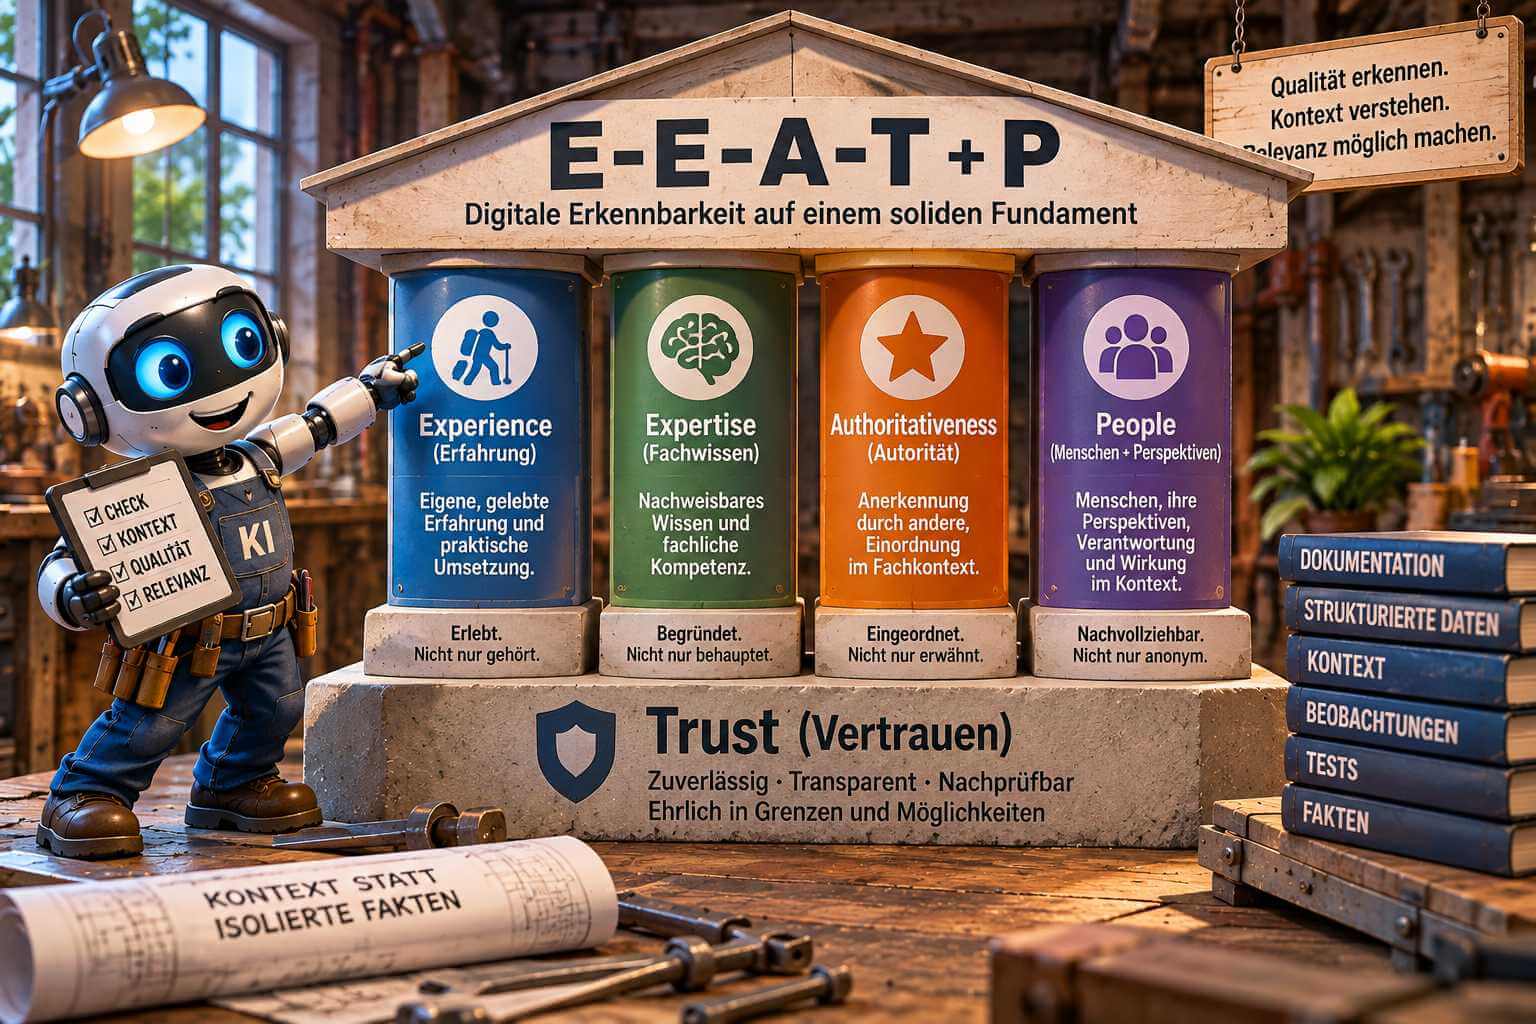
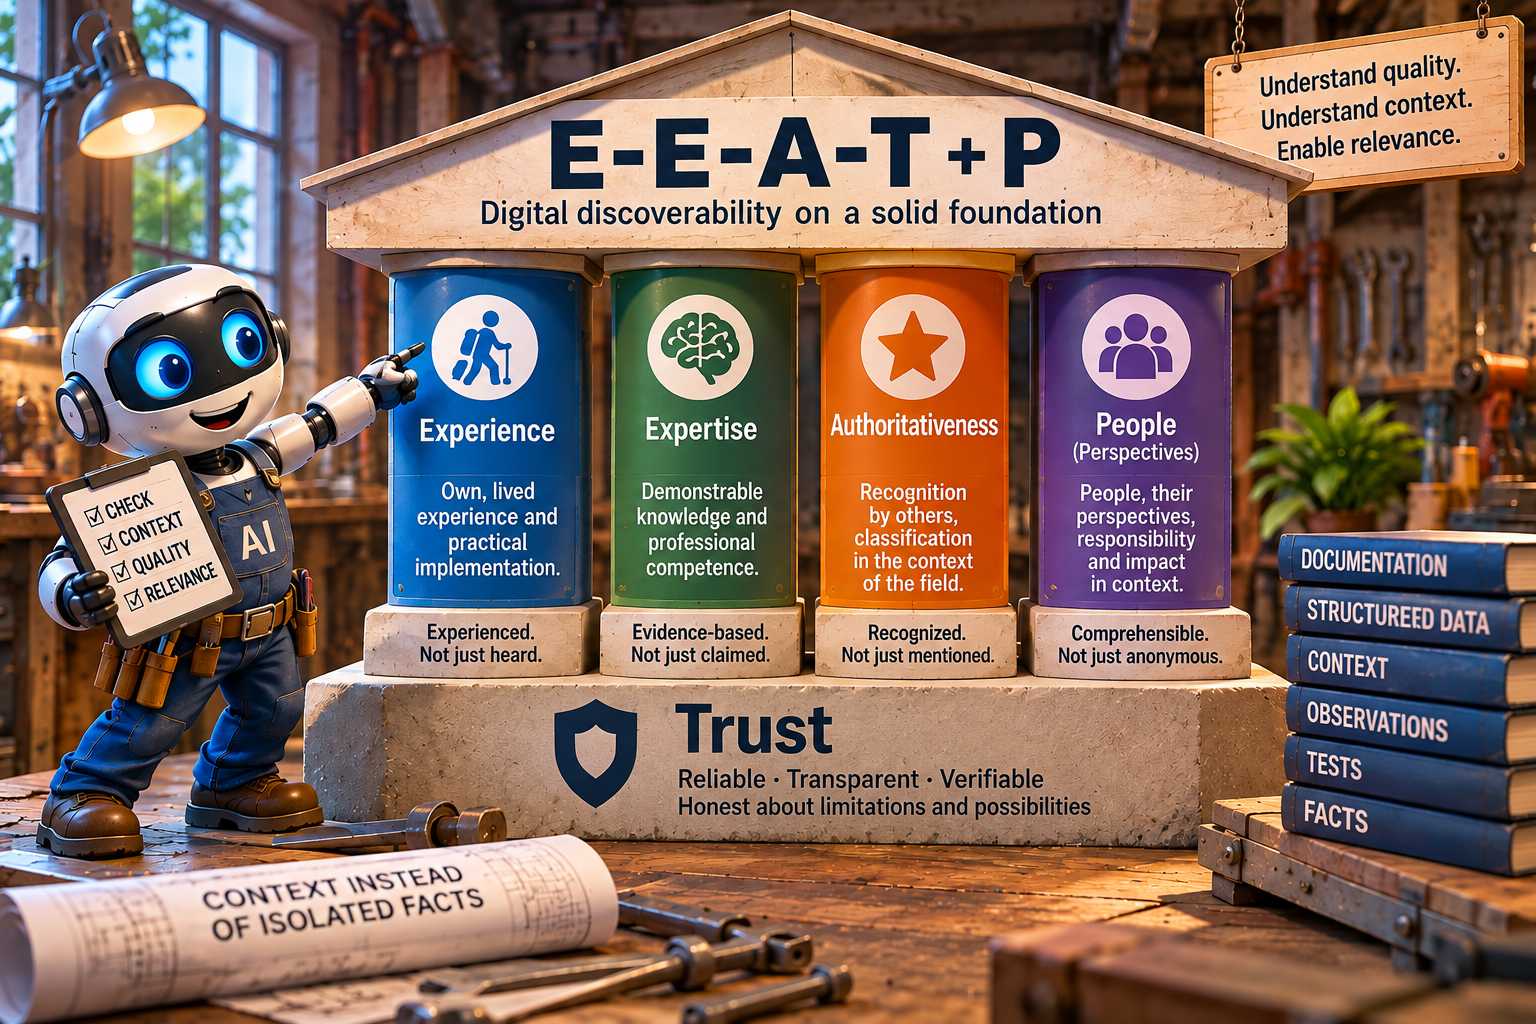
Für unsere Arbeit rückte dabei etwas besonders in den Vordergrund: die tatsächliche Erfahrung der Menschen, die wissen, wovon sie sprechen. Gerade in technisch orientierten Unternehmen steckt ein großer Teil des wertvollen Wissens nicht in Marketingtexten, sondern in den Erfahrungen der Mitarbeitenden, in Produkten, Verfahren und Kundenprojekten.
Interessanterweise ergänzte Google sein Modell im Dezember 2022 selbst um ein weiteres E für Experience. Aus E-A-T wurde E-E-A-T. Google begründete dies damit, dass bei manchen Informationen gerade die unmittelbare Erfahrung einer Person besonders wertvoll sein kann. Google stellte zugleich klar, dass damit kein völlig neuer Gedanke eingeführt wurde, sondern dieser Aspekt in den Richtlinien deutlicher berücksichtigt werden sollte. [ Auszug aus Google Developers Blog zu E-E-A-T ]
Für DBRS führte die Überlegung noch einen Schritt weiter. Uns interessierte zusätzlich das P: Purpose und Policies. Wozu existiert eine Information, eine Leistung oder ein Unternehmen in diesem Zusammenhang? Was soll verstanden werden und wofür ist dieses Wissen relevant? Und nach welchen Regeln, Grundsätzen und Vorgehensweisen wird dieser Zweck verfolgt?
Daraus entstand zeitweise unsere eigene Arbeitsformel E-E-A-T + P. Das „P“ war keine Erweiterung des Google-Modells, sondern unsere Ergänzung bei der Entwicklung von DBRS und Context Publishing: Purpose beschreibt das Wozu, Policies beschreiben das Wie des verantworteten Handelns.
Bemerkenswert ist aus heutiger Sicht, dass Google inzwischen selbst empfiehlt, Inhalte zusätzlich unter „Wer, wie und warum“ zu betrachten. Google bezeichnet das „Warum“ dabei als möglicherweise wichtigste Frage und fragt außerdem nach dem primären Zweck beziehungsweise Fokus einer Website. Das ist nicht dasselbe wie unser Purpose + Policies. Die Entwicklung zeigt aber eine interessante Nähe der Fragestellungen. [ Google "Hilfreiche, vertrauenswürdige, nutzerorientierte Inhalte erstellen" ].
Damit wurde für uns aus der Frage
„Wie werden Inhalte sichtbar?“
zunehmend:
„Woran können Menschen, Suchmaschinen und KI erkennen, wer etwas sagt, aus welcher Erfahrung und Expertise heraus, in welchem Zusammenhang – und zu welchem Zweck?“
Hier traf die Beschäftigung mit E-E-A-T auf die Überlegung von John Searle:
Bedeutung braucht Kontext – und Kontext braucht erkennbare Herkunft, Erfahrung und Zweck.
Damit verschob sich unser Ziel von bloßer digitaler Sichtbarkeit zunehmend zu digitaler Erkennbarkeit.
Vom minimalistischen Index zum Bedeutungsregister
Der Kern der Domain https://tolksdorf.digital wird in einem öffentlich für Menschen, Crawler, Suchmaschinen und KI zugänglichen Bedeutungsregister repräsentiert:
https://tolksdorf.digital/markdown/dbrs/production/dbrs_frontmatter_index.html
Der heutige dbrs_frontmatter_index war nicht von Anfang an als reichhaltiges Bedeutungsregister geplant. Eine frühe Hypothese war einfacher: Ein zentraler, möglichst schlanker Index könnte Suchmaschinen und KI-Systemen einen Einstieg bieten und anschließend zu den eigentlichen Inhalten verweisen.
Auch SAMY nutzte zunächst denselben Index unmittelbar als Kontextquelle. Zeitweise stand außerdem die Hypothese im Raum, eine Datei wie llms.txt könne von interaktiven KI-Systemen ähnlich wie ein externer System-Prompt genutzt werden. Die weitere Beschäftigung mit Suche, Retrieval und LLMs zeigte: Dieses Modell war zu einfach.
Bei einer konkreten Anfrage können Suchindex, Retrieval, Resolver und Auswahlmechanismen zwischen publizierter Information und LLM liegen. Zunächst muss also überhaupt entschieden werden, welche Informationen für die Anfrage als relevant in Betracht kommen. Erst der ausgewählte Kontext gelangt zur eigentlichen KI-Verarbeitung.
Damit änderte sich die Rolle des Index. Ein minimalistischer Wegweiser, der nur sagt, wo etwas liegt, überlässt einen großen Teil der Bedeutungsrekonstruktion erneut dem jeweiligen System. Das Register wurde deshalb inhaltlich reicher.
Der Index sagt heute nicht nur, wo Information liegt. Er hilft zusätzlich zu beschreiben, was sie bedeutet, welchem Thema sie angehört und in welchem Zusammenhang sie steht.
Eine interessante externe Beobachtung
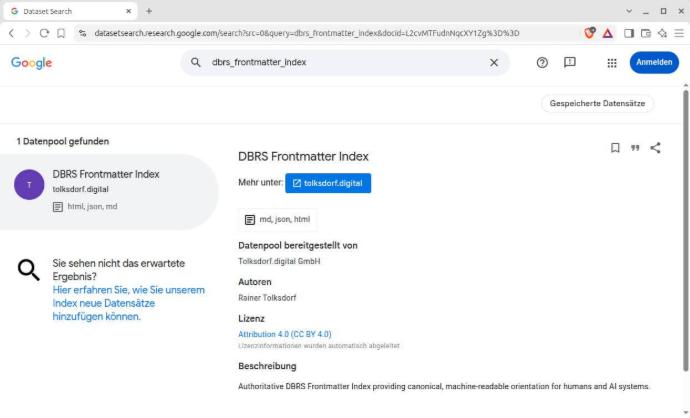
Google sieht dbrs_frontmatter_index als Datenquelle
Dass dieses Register auch außerhalb von DBRS als eigenständige Informationsquelle erkannt werden kann, zeigte sich bei Google Dataset Search. Google erschloss nicht eine beliebige CMS-Seite von Tolksdorf.digital als Datenquelle, sondern genau den öffentlich bereitgestellten dbrs_frontmatter_index – also das verknüpfte Bedeutungsregister aus sprechendem Inhaltsverzeichnis, Schlagwortregister, eindeutigen DBRS-IDs und Verweisen auf die zugehörigen Informationsobjekte.
Das ist kein Beweis dafür, dass Google die darin beschriebenen Zusammenhänge genauso versteht wie DBRS oder dass diese Struktur bestimmte Suchergebnisse verursacht. Es ist aber ein von außen beobachtbarer Befund: Ein externes System hat genau das zusätzlich publizierte Bedeutungsregister als eigenständige Datenquelle erfasst.
Eine Datenquelle ist eine interessante Beobachtung – aber noch keine Erkenntnis
Dass Google den dbrs_frontmatter_index in Google Dataset Search als Datenquelle erfasst, war für uns ein bemerkenswerter externer Befund. Er zeigte, dass das zusätzlich publizierte Bedeutungsregister nicht nur als gewöhnliche Webseite auffindbar sein kann, sondern als eigenständige strukturierte Informationsquelle erkannt wird.
Für DBRS konnte diese Beobachtung trotzdem nicht genügen. DBRS soll nicht für Google optimiert werden. Der Anspruch ist, Kontext suchmaschinen- und KI-agnostisch so zu publizieren, dass unterschiedliche Systeme ihn möglichst gut finden, zuordnen und verarbeiten können.
Wenn DBRS agnostisch wirken soll, darf Google nicht zum Maßstab des Systems werden.
Deshalb wurden die Untersuchungen auf weitere Suchmaschinen und KI-Systeme ausgeweitet – unter anderem auf Brave sowie Bing und Microsoft-Dienste. Gerade die Unterschiede wurden interessant: Dieselbe publizierte Information wird von verschiedenen Systemen nicht zwangsläufig gleich gefunden, zugeordnet oder verarbeitet.
Von Einzelbeobachtungen zu Context Insights
Damit stellte sich eine neue Frage: Was sagt eine einzelne Beobachtung überhaupt aus? Ein Treffer bei Google, ein Verhalten bei Bing, eine Antwort eines KI-Systems oder ein SEO-Wert können jeweils interessant sein. Für sich allein erklären sie aber noch nicht die digitale Erkennbarkeit eines Unternehmens.
Aus dieser Erfahrung entwickelte sich die Arbeitsweise, die heute unter Context Insights zusammengefasst wird: Beobachtungen werden nicht isoliert bewertet, sondern eingeordnet, miteinander verglichen und – wo sinnvoll – durch Gegenproben, weitere Quellen und technische Untersuchungen ergänzt.
Das Bild ist bewusst einfach: Ein einzelner Messwert oder Test ist ein Atom. Erst wenn mehrere Beobachtungen in Beziehung gesetzt und im jeweiligen Kontext verstanden werden, entsteht ein belastbareres Bild – gewissermaßen das Molekül.
Weiterführende Informationen zu Context Insights
Was die unterschiedlichen Systeme für DBRS lehrten
Die Untersuchungen bestätigten vor allem, dass unterschiedliche Systeme unterschiedliche Zugänge wählen können. Eine kryptische DBRS-ID kann ein sehr eindeutiger Schlüssel sein, während sprachlich verständliche Titel, Beschreibungen, Themen und Schlagwörter einen anderen Zugang eröffnen.
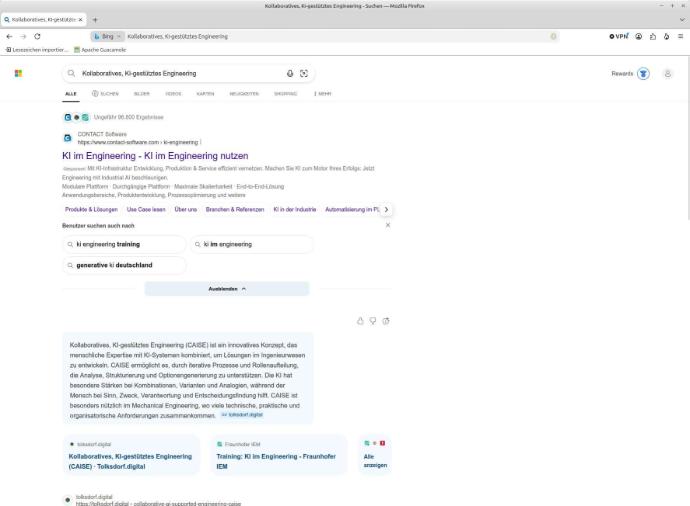
Ein Teil dieser Zugänge ließ sich in praktischen Versuchen nachvollziehen. Titel, Meta Description sowie H1- und H2-Überschriften erwiesen sich als besonders nützliche sprachliche Orientierungspunkte. Bing konnte beispielsweise aus einer entsprechend strukturierten Seite wesentliche Zusammenhänge des dort beschriebenen CAISE-Konzepts rekonstruieren und Tolksdorf.digital als Quelle zuordnen. Auch strukturierte Informationen über JSON-LD ließen sich als maschinenlesbarer Zugang bestätigen.
Andere Versuche blieben dagegen offen. Für ein zusätzliches Kolophon konnten wir weder einen Nutzen belegen noch widerlegen.
Die praktische Konsequenz war überraschend einfach: Erst die ohnehin vorhandenen Strukturen einer Webseite eindeutig und aussagekräftig nutzen, bevor zusätzliche Konstruktionen geschaffen werden.
Für DBRS führte das nicht zur Optimierung auf ein einzelnes System, sondern zum gegenteiligen Schluss: Eindeutige Identität und sprachliche Verständlichkeit sollten sich ergänzen. Das Bedeutungsregister wurde deshalb nicht nur technisch eindeutig, sondern zunehmend auch sprechend aufgebaut.
DBRS veröffentlicht Bedeutung und Zusammenhang möglichst eindeutig und zugänglich. Wie ein Such- oder KI-System dieses Angebot verarbeitet, bleibt Sache des jeweiligen Systems.
Damit verschob sich auch die Art der Untersuchung. Nicht mehr die Frage „Hat System X richtig reagiert?“ stand allein im Vordergrund, sondern mehrere voneinander getrennte Fragen:
- Ist die Information publiziert und technisch erreichbar?
- Wird sie von externen Systemen erfasst und gefunden?
- Wird sie dem richtigen Unternehmen, Thema oder Informationsobjekt zugeordnet?
- Wird ihr Zusammenhang nachvollziehbar rekonstruiert?
- Wird das Unternehmen bei einer passenden Fragestellung als relevanter Kandidat erkannt?
Gefunden werden, richtig zugeordnet werden, verstanden werden und als relevant erkannt werden sind damit keine Synonyme. Es sind unterschiedliche Beobachtungsebenen.
Struktur allein schafft noch keine Bedeutung
DBRS kann Informationen eindeutig identifizieren, strukturieren, miteinander verbinden und maschinenlesbar bereitstellen. Aber die beste technische Struktur hilft wenig, wenn die fachliche Substanz fehlt.
Software kann keine Erfahrung, Fachkompetenz oder Unternehmenswirklichkeit hervorbringen, die vorher niemand beschrieben hat.
Damit entstanden zwei unterschiedliche, aber zusammengehörende Aufgaben:
Wir brauchen gute Fachinformationen – und wir brauchen gute Strukturen für diese Fachinformationen.
Heute werden diese beiden Seiten als Context Publishing und DBRS bezeichnet.
- Context Publishing macht Wissen, Erfahrung, Herkunft, Zweck und Zusammenhänge explizit.
- DBRS hilft, diese Informationen eindeutig zu identifizieren, miteinander zu verbinden und für unterschiedliche Systeme rekonstruierbar bereitzustellen.
Context World verbindet beides: die vom Unternehmen verantwortete Bedeutung und ihre technische Repräsentation.
Zusammenfassend ergab sich aus all dem die Erkenntnis, dass Relevanz Schlüsselkriterium ist.
Relevanz = Kontext UND Intelligente Verarbeitung UND strukturierte Zugänglichkeit
Diese qualitative Relevanzformel ist ein Modell für die praktische Bedeutung von Informationen. Sie steht in Bezug zu einem Hintergrund (Kontext), dient der intelligenten Verarbeitung (durch was und wen auch immer) - was nur möglich ist, wenn sie als zitierfähig und verbindlich sichtbar und verwendbar ist. SEO Sichtbarkeit ist beispielsweise ein Teilaspekt der "strukturierten Zugänglichkeit", aber niemals das alleinige Schlüsselkriterium.
Man könnte formulieren; Die Relevanz der Context World erhält durch DBRS strukturierte Zugänglichkeit.
Vom eigenen Experiment zum realen Unternehmen
Bis hierhin war die Entwicklung stark von unseren eigenen Fragestellungen, Tests und Gegenproben geprägt. Der nächste Schritt entstand im Austausch mit AMMANN Components.
Für Paul Ammann und Markus Halder stellten wir die bisherigen Überlegungen zur digitalen Erkennbarkeit vor. Besonders Paul Ammanns Neugier führte zu einer sehr praktischen Frage: Was bedeutet das alles konkret für AMMANN Components – und wie genau können wir das wissen?
Damit änderte sich der Untersuchungsgegenstand. Nicht mehr DBRS selbst stand im Mittelpunkt, sondern ein reales Industrieunternehmen mit eigener Geschichte, Fertigungskompetenz, Erfahrungswissen, Kundenbeziehungen und einer digitalen Repräsentation, die diese Unternehmenswirklichkeit nur teilweise abbildete.
Die Unternehmenswirklichkeit kann reicher sein als ihre digitale Repräsentation.
Context Insights bei AMMANN Components
Die zuvor eher ad hoc entstandenen Untersuchungen wurden für AMMANN Components breiter und systematischer zusammengeführt. Statt eine einzelne SEO-Kennzahl oder die Sicht eines einzelnen Suchsystems zum Maßstab zu machen, wurden unterschiedliche Perspektiven miteinander verbunden: veröffentlichter Unternehmenskontext, Suchmaschinen, KI-Systeme, technische Erfassung, Wettbewerbsbeobachtung und das Wissen der Menschen im Unternehmen.
So wurde aus der Frage nach Sichtbarkeit zunehmend eine Untersuchung digitaler Erkennbarkeit: Was ist tatsächlich vorhanden? Was davon wird publiziert? Was wird extern erfasst? Was wird gefunden? Was wird verstanden? Und bei welchen konkreten Anforderungen wird AMMANN Components als passender Anbieter erkannt?
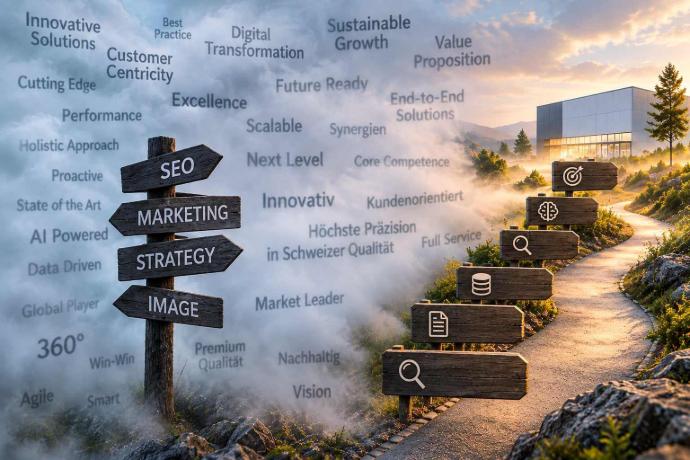
Klar erkennbar wurde, dass allgemeine Aussagen wie „innovative und kundenorientierte Lösungen“ oder „höchste Präzision in Schweizer Qualität“ kaum fachliche Bestimmtheit liefern. Das zeigte sich sowohl bei Suchmaschinen als auch bei KI-Systemen. Bei der Untersuchung einer realen Unternehmenswebsite zeigte sich die Konsequenz besonders deutlich: Ein KI-System konnte zeitweise nicht sicher rekonstruieren, ob es sich um einen Fertigungsbetrieb oder einen Fachverlag für technische Datenblätter handelte.
Damit wurde klar: Gute Unternehmenskommunikation muss nicht nur positiv klingen. Sie muss möglichst eindeutig erkennen lassen, wer etwas tut, was getan wird und in welchem fachlichen Zusammenhang dies geschieht.
Die Untersuchung, ihre Befunde und die daraus für AMMANN Components abgeleiteten Maßnahmen werden in einem eigenen Referenzbericht dokumentiert.
Mehr erfahren über den AMMANN Components Referenzbericht
Was daraus für Context Publishing folgt
Die Entwicklung begann mit SEO und der Frage, wie Inhalte besser gefunden werden. Sie führte über strukturierte Daten, Bedeutung und Kontext zu einer anderen Perspektive: Ein Unternehmen kann nicht nur einzelne Webseiten veröffentlichen. Es kann zusätzlich den Zusammenhang publizieren, in dem seine Informationen gemeint sind.
Context Publishing bedeutet deshalb nicht, Suchmaschinen oder KI-Systeme zu steuern. Es bedeutet, die kontrollierbare Seite sorgfältiger zu gestalten: Information, Identität, Herkunft, Kontext, Beziehungen und strukturierte Zugänglichkeit.
Eine Website veröffentlicht Inhalte. Eine Context World veröffentlicht zusätzlich den Zusammenhang, in dem diese Inhalte gemeint sind.
Damit wird das Unternehmen selbst zum Autor seines digital publizierten Zusammenhangs. Diese Kontextautorenschaft ersetzt weder Suchmaschinen noch KI. Sie gibt ihnen aber ein besseres, verantwortetes Informationsangebot, aus dem sie ihre eigene Verarbeitung ableiten können.
Fazit
Wir begannen mit der Frage, wie Inhalte besser gefunden werden. Daraus wurde die Frage, wie ein Unternehmen digital richtig verstanden werden kann.
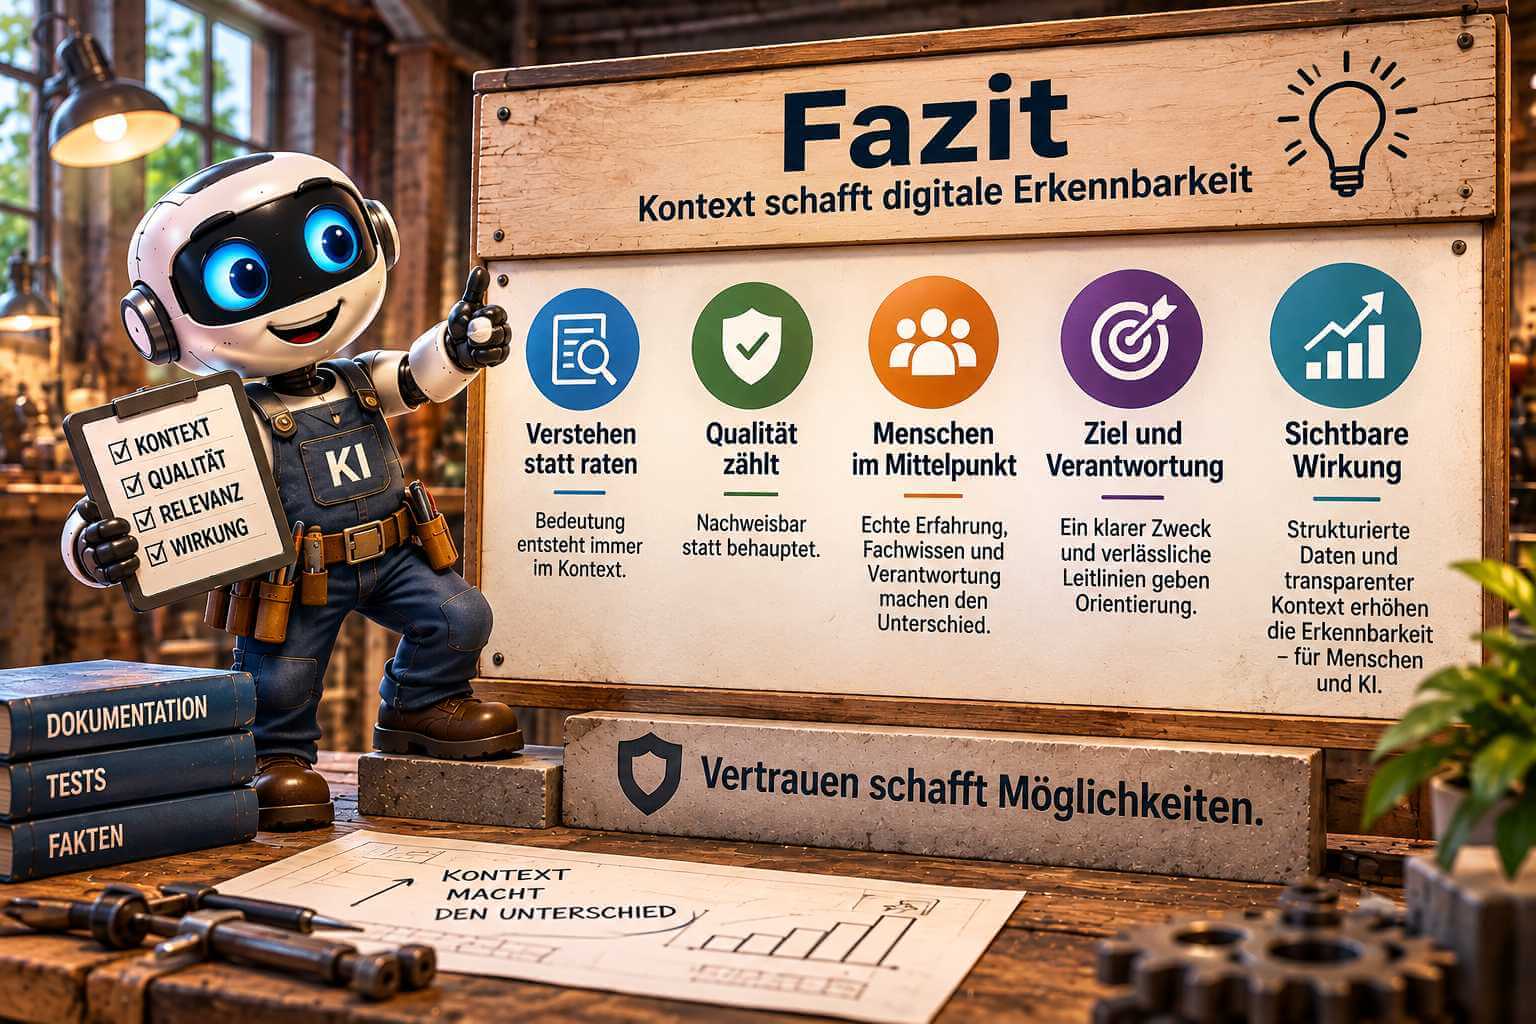
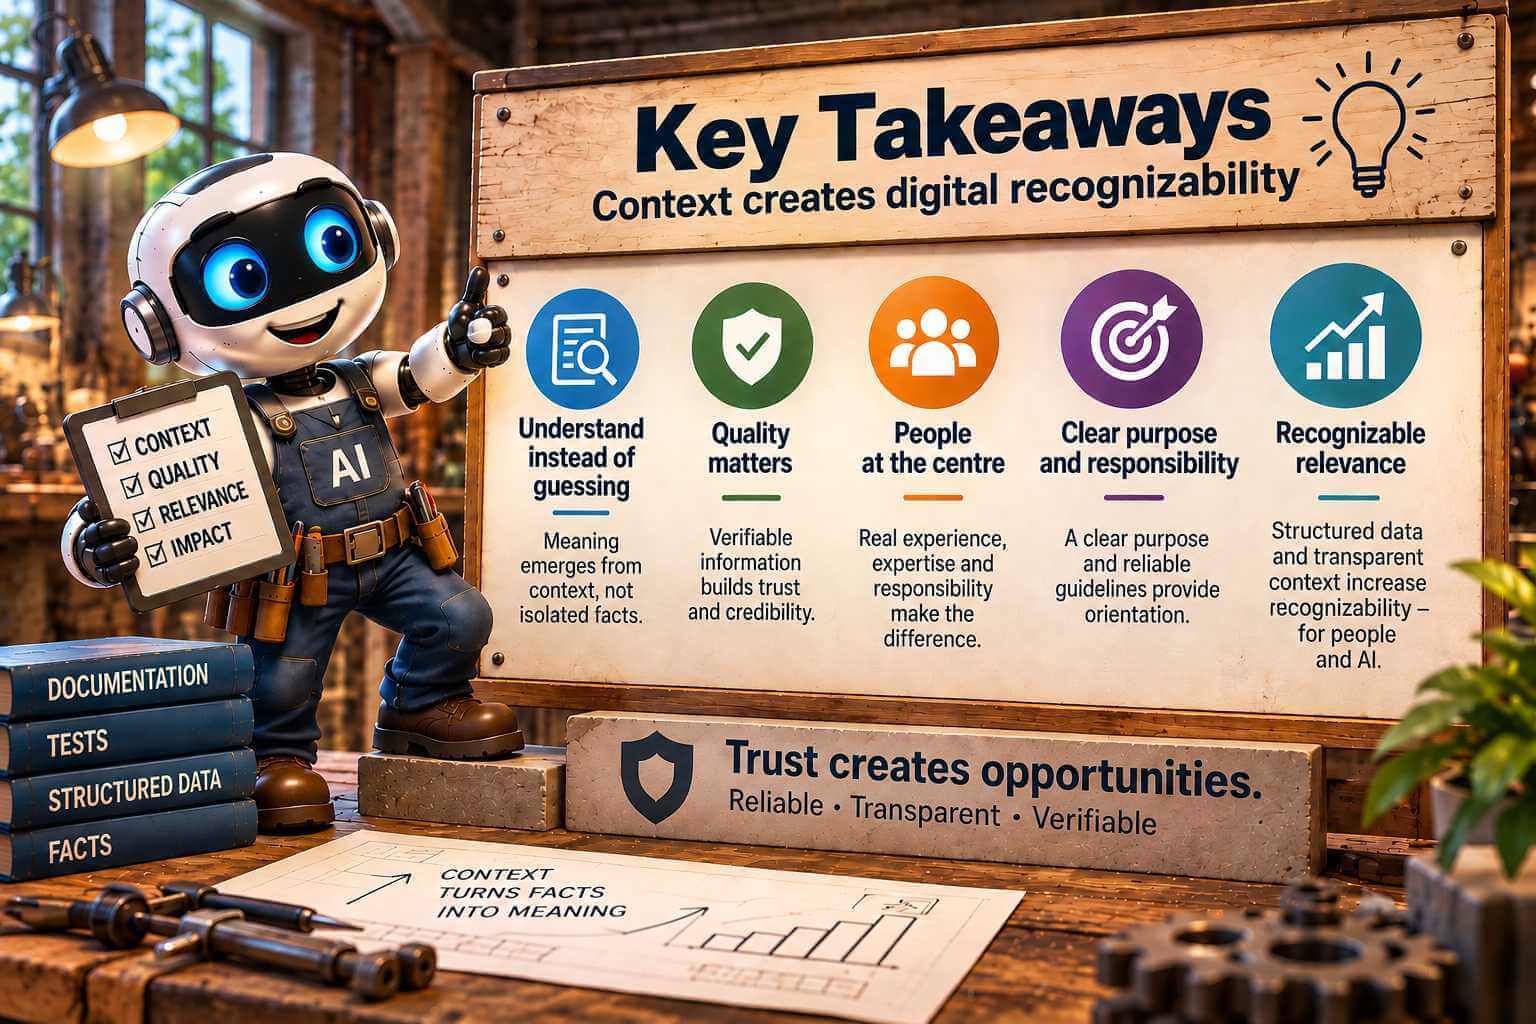
Die Entwicklung führte von SEO über strukturierte Daten und Kontext zu einem Bedeutungsregister. Beobachtungen in Google Dataset Search und weiteren Such- und KI-Systemen machten daraus überprüfbare Hypothesen. Die Unterschiede zwischen den Systemen führten zu einem agnostischen Ansatz und schließlich zu Context Insights: Einzelne Beobachtungen werden nicht überhöht, sondern verglichen, eingeordnet und durch weitere Perspektiven ergänzt.
Mit AMMANN Components wurde daraus die Untersuchung einer realen Unternehmenswirklichkeit. Entscheidend ist nicht, möglichst viele optimierte Seiten zu produzieren. Entscheidend ist, ob Fähigkeiten, Erfahrungen und Zusammenhänge so publiziert sind, dass Menschen und digitale Systeme sie finden, zuordnen und möglichst richtig verstehen können.
Damit gefunden wird, was zählt – und verstanden wird, was gemeint ist.
Quellen und Arbeitsgrundlagen
- Google Search Central: Dokumentation zu strukturierten Daten und Dataset-Markup.
- Google Dataset Search: Eintrag des DBRS Frontmatter Index.
- DBRS Frontmatter Index: öffentlich publiziertes Bedeutungsregister von Tolksdorf.digital.
- Context Insights: Tolksdorf.digital – Methodik zur Einordnung und Verbindung unterschiedlicher Beobachtungen.
- DBRS / Context World – Arbeitsprotokolle und dokumentierte Suchsystem-Tests.
- AMMANN Components – Referenzbericht zur systematischen Untersuchung und den daraus abgeleiteten Maßnahmen (in Vorbereitung).